Le harness, c'est quoi ?
Un modèle d'IA seul, c'est un moteur posé sur un établi. Il tourne, il fait du bruit, mais il ne t'emmène nulle part.
Le harness (harnais, en français), c'est tout ce qu'on monte autour pour en faire une voiture : les instructions qu'on lui donne, les outils qu'il peut utiliser, les fichiers de contexte qu'il lit au démarrage, les tests qui vérifient son travail, les règles sur ce qu'il a le droit de toucher.
Quand tu utilises Claude Code ou Codex, une partie de ce harness est fournie par l'outil. L'autre partie, c'est toi qui la construis : ton CLAUDE.md, tes consignes, tes tests, ta manière de découper le travail. Si le mot « agent » ne te parle pas encore, commence par le guide de l'agentic coding.
Le mot a explosé au printemps 2026 sous le nom de harness engineering, l'art de bien construire cet environnement. Et presque au même moment, une autre idée a commencé à circuler : les modèles deviennent si bons que tout ça ne servira bientôt plus à rien.
La tentation : tout jeter
L'argument est séduisant, et il n'est pas faux. Chaque génération de modèle a rendu obsolète une partie des astuces de la précédente.
Les chercheurs en IA ont un nom pour ça : la bitter lesson, la leçon amère. Rich Sutton l'a formulée en 2019 : sur la durée, les méthodes qui misent sur la puissance de calcul finissent par battre celles qui misent sur l'ingéniosité humaine. Les montages astucieux qu'on construit pour aider un modèle sont souvent balayés par le modèle suivant.
Ma position : les modèles rendent inutile la moitié du harness. Et ils rendent l'autre moitié plus importante que jamais. Tout l'enjeu, c'est de savoir laquelle est laquelle.
La moitié que les modèles ont déjà mangée
Tout ce qui servait à compenser les faiblesses du modèle disparaît à mesure que ces faiblesses disparaissent.
Les formules magiques. « Tu es un développeur senior avec 20 ans d'expérience. » « Réfléchis étape par étape. » « C'est très important pour ma carrière. » En 2023, ces phrases amélioraient vraiment les réponses. Aujourd'hui, les modèles raisonnent avant de répondre sans qu'on le leur demande. Ces formules ne coûtent rien, mais elles ne rapportent plus rien non plus.
Les fichiers de règles géants. Les packs de 2 000 lignes de « rules » copiés d'un forum, qui expliquent au modèle comment écrire un composant React ou nommer une variable. Un modèle actuel sait déjà le faire. Mieux : il lit le reste de ton code et en déduit tes conventions tout seul.
Le découpage au millimètre. Il y a deux ans, il fallait découper chaque tâche en micro-étapes, sinon le modèle perdait le fil au milieu. Les agents actuels font leur propre plan, tiennent une liste de tâches et reviennent dessus.
Les montages multi-agents faits maison. Un agent « architecte », un agent « développeur », un agent « testeur » qui se passent la main via des scripts bricolés. Les outils intègrent maintenant ce fonctionnement, et un seul agent bien briefé fait souvent mieux que la chaîne.
Te répéter à chaque message. Les modèles retiennent beaucoup plus de contexte, et les outils savent le résumer quand il déborde. Tu n'as plus besoin de recoller ton schéma de base de données dans chaque demande.
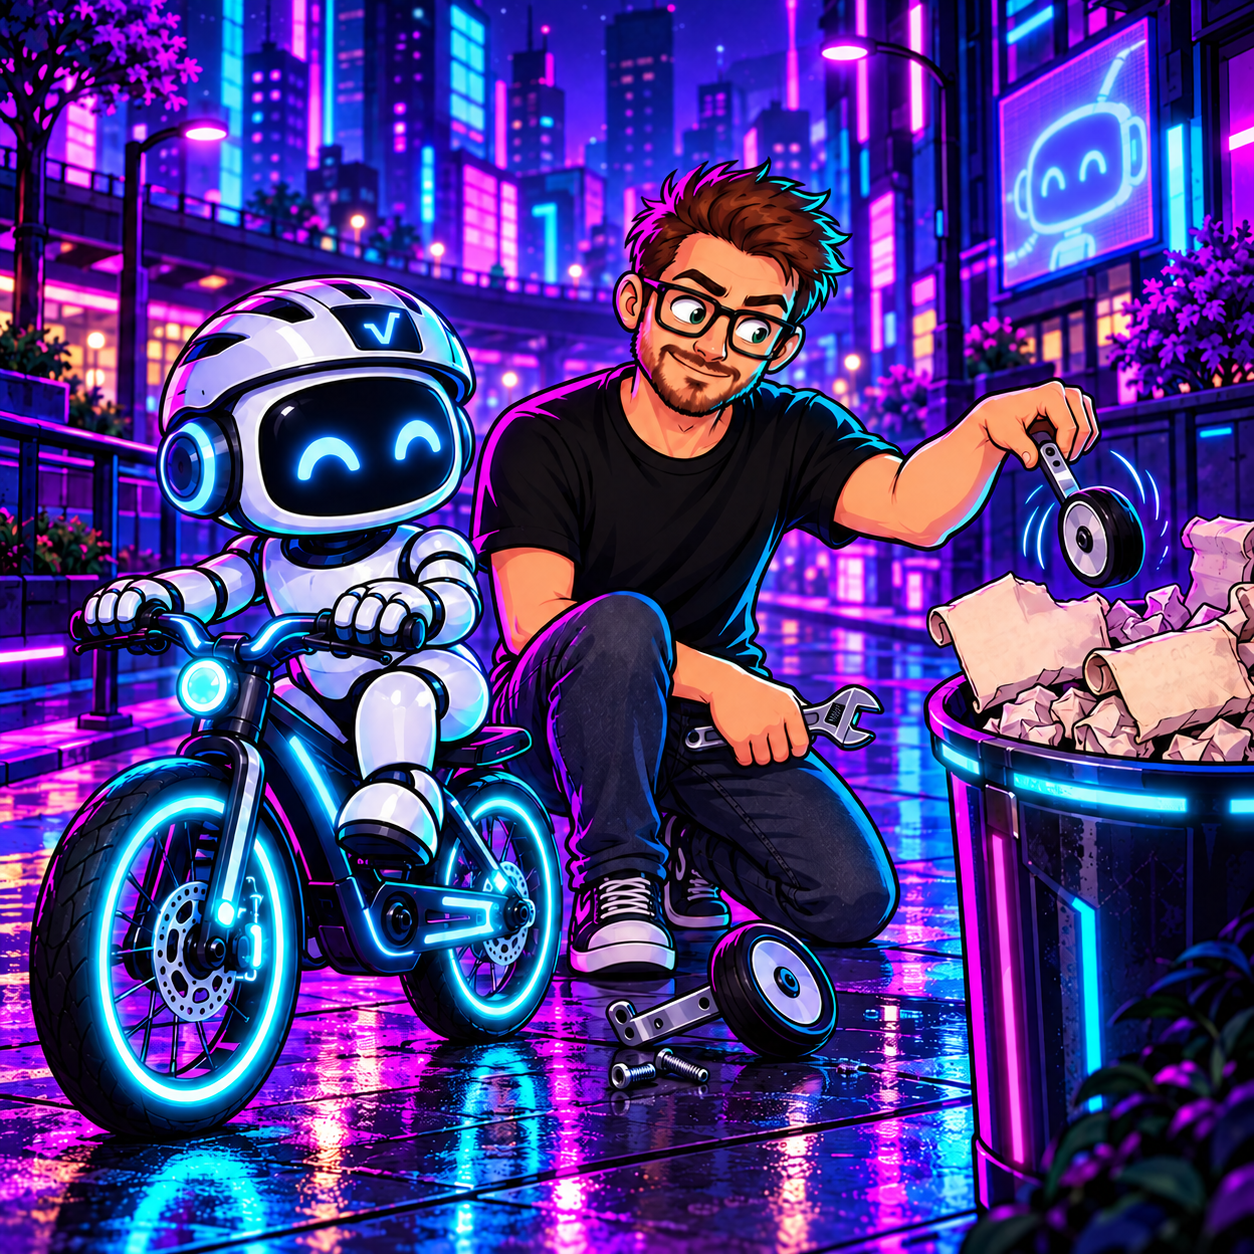
Le point commun : tout ça, c'étaient des petites roues sur un vélo. Le modèle a appris à tenir en équilibre, on peut les enlever.
La moitié qui prend de la valeur
L'autre moitié du harness ne compense pas une faiblesse du modèle. Elle apporte ce que le modèle ne peut pas savoir, quelle que soit sa puissance.
Ton contexte métier. Le modèle ne sait pas que tes clients sont des pharmacies, qu'un remboursement doit être validé par un humain, ou que tu as abandonné les abonnements annuels l'an dernier parce qu'ils généraient trop de litiges. Ce n'est écrit nulle part dans ton code. Un modèle dix fois plus intelligent ne le devinera pas mieux.
Ta définition de « ça marche ». Un agent s'arrête quand il pense avoir fini. S'il n'existe aucun test pour lui prouver le contraire, il a raison de son point de vue. Les tests, c'est la manière d'écrire noir sur blanc ce qui doit marcher : un client peut payer, un utilisateur ne voit pas les données d'un autre, une facture part bien. L'agent peut écrire ces tests. Il ne peut pas décider lesquels comptent pour ton business.
La vérification automatique. La CI (intégration continue : un robot qui relance tous les tests à chaque modification et bloque si quelque chose casse) n'est pas là pour la modification d'aujourd'hui. Elle est là pour celle de mardi prochain, qui cassera sans prévenir ce qui marchait la semaine d'avant.
Les garde-fous. Ce que l'agent a le droit de toucher : pas les clés de la base de production, pas la configuration des paiements sans relecture, pas de suppression de données sans sauvegarde. Un modèle plus puissant fait moins d'erreurs, mais celles qu'il fait vont plus vite et plus loin.
Les yeux sur la production. L'agent ne voit pas ce qui se passe chez tes utilisateurs. Si personne ne lui montre les erreurs, il continue d'améliorer une app qui plante chez la moitié de tes clients.
Reviens à la voiture : un moteur deux fois plus puissant ne rend pas les freins inutiles, il les rend indispensables. Et il ne sait toujours pas où tu veux aller.
| Ce qui compense une faiblesse du modèle | Ce qui apporte ce que le modèle ignore | |
|---|---|---|
| Exemples | Formules magiques, rules génériques, micro-étapes, chaînes d'agents | Contexte métier, tests des parcours critiques, CI, droits d'accès, alertes |
| Avec un meilleur modèle | Devient inutile, parfois gênant | Prend de la valeur |
| Qui doit l'écrire | Bientôt personne | Toi, ou quelqu'un qui connaît ton produit |
Plus le modèle est fort, plus la vérification compte
C'est le point le moins intuitif. Un modèle plus fort produit plus de code, plus vite, avec moins d'erreurs visibles. Résultat : tu relis moins, tu fais plus confiance, et tu laisses passer des changements plus gros.
Les erreurs qui restent sont aussi les plus discrètes. L'IA réussit souvent le plus dur et rate le plus bête : une règle d'accès oubliée, un paiement compté deux fois, un webhook qui échoue en silence. Le code est propre, l'app a l'air de marcher, et le problème apparaît trois semaines plus tard.
Quand ton agent écrivait 50 lignes par jour, tu pouvais tout relire. Quand il en écrit 5 000, seuls les tests et la CI suivent le rythme.
Le piège : jeter les deux moitiés en même temps
Il y a deux erreurs symétriques.
Tout garder, par peur. Ton fichier de consignes a grossi depuis 2024. Il contient des règles écrites pour un modèle qui n'existe plus : « utilise toujours telle version de telle librairie », « ne modifie jamais plus de trois fichiers à la fois ». Le modèle actuel les suit à la lettre, et elles le freinent. Des consignes obsolètes ne sont pas neutres.
Tout jeter, par enthousiasme. « Le nouveau modèle est incroyable, plus besoin de tests. » C'est retirer les freins parce que la voiture accélère mieux. Tant que tout va bien, tu ne vois pas la différence.
Le bon réflexe, c'est le tri.
Le grand ménage : une checklist en 15 minutes
Ouvre ton CLAUDE.md (ou AGENTS.md, ou tes rules Cursor) et passe chaque ligne à cette question : est-ce que le modèle pourrait le deviner en lisant mon code ?
- Oui : supprime. Les conventions de nommage, la description de la stack, la manière d'écrire un composant, les « sois rigoureux » et « réfléchis bien ».
- Non : garde, et précise. Ce que fait ton produit et pour qui, les décisions passées et leur raison, ce qui est interdit, les zones sensibles comme le paiement ou les données personnelles.
Ensuite, vérifie ce qui entoure l'agent :
- Les 3 parcours qui font vivre ton business ont-ils des tests ? En général : l'inscription, le paiement, l'accès aux données d'un client.
- Ces tests tournent-ils automatiquement à chaque modification, ou seulement quand quelqu'un y pense ?
- Ton agent a-t-il accès à la production ? Si oui, retire-lui ces accès et fais-le travailler sur une copie.
- Tes sauvegardes sont-elles testées ? Une sauvegarde qu'on n'a jamais restaurée reste une hypothèse.
- Quelqu'un relit-il les changements sur l'authentification et les paiements avant leur mise en ligne ?
- Sais-tu quand ton app plante chez un utilisateur sans qu'il ait à t'écrire ?
Si tu réponds non à plus de deux de ces questions, ce n'est pas la puissance de ton modèle qui te limite.
Alors, le harness est-il condamné ?
La partie du harness qui disait au modèle comment travailler est en train de disparaître, et c'est une bonne nouvelle. Tu as moins de prompts à écrire et moins de recettes à suivre.
La partie qui dit ce qui compte, ce qui est interdit et comment savoir si c'est réussi ne disparaîtra pas. C'est le cahier des charges, le contrôle qualité et l'assurance. Elle ne dépend pas de l'intelligence du modèle, elle dépend de ton produit.
Je pense même que c'est là que se jouera la différence entre deux apps construites avec le même modèle. Elles ont accès à la même intelligence. Ce qui les sépare, c'est ce qu'on a mis autour. C'est aussi pour ça que les agents ne remplacent pas ceux qui savent les encadrer.
Tu veux un harness solide autour de ton app ?
Je mets en place la moitié qui ne disparaîtra pas : des tests sur tes parcours critiques, une CI qui bloque avant la casse, des accès cloisonnés et un fichier de contexte qui parle de ton métier. Si ton app existe déjà, l'audit de code te dit ce qui manque. Si tu préfères confier ton produit, découvre l'offre ou parlons de ton projet.
Et pour recevoir d'autres articles sur la construction de produits avec l'IA, inscris-toi à la newsletter.